Публикации

Типовой технологический стек российского госпортала: веб-серверы, БД, интеграционные шины

Типовой технологический стек российского госпортала: веб-серверы, БД, интеграционные шины

Почему у госпортала не бывает «одного сервера»
Пользователь открывает одну страницу, а за ней в этот момент могут работать пять-шесть независимых контуров: публикация контента, авторизация, личный кабинет, проверка данных в реестрах, отправка уведомлений, платёжный шлюз и журналирование событий. Такое разделение — не прихоть архитекторов, а осознанная необходимость. Если модуль приёма заявлений «ляжет» под пиковой нагрузкой, остальные […]
Сравнение интерфейсов Госуслуг и коммерческих сервисов: чему государственным ресурсам можно научиться у рынка

Сравнение интерфейсов Госуслуг и коммерческих сервисов: чему государственным ресурсам можно научиться у рынка

Когда пользователь заходит на портал Госуслуг, чтобы записать ребёнка в детский сад, а за минуту до этого он заказал пиццу в приложении с тремя нажатиями, у него возникает когнитивный диссонанс. Не потому что он ждёт от государства такого же интерфейса, как у доставки еды. А потому что базовые принципы удобства — понятность, скорость, предсказуемость — уже стали […]

Юзабилити-гайд для госпорталов: удобство интерфейсов через призму современных веб-практик

Юзабилити-гайд для госпорталов: удобство интерфейсов через призму современных веб-практик

Госпортал перестал быть «местом, куда заходят по необходимости». Сегодня от него ждут того же, что и от хорошего коммерческого сервиса: понятного сценария, предсказуемой навигации, быстрого отклика и отсутствия лишних шагов. Если интерфейс заставляет думать, где нажать, что заполнить и почему система ругается — пользователь уходит раздражённым, даже если задача формально решена.

Ниже — практический гайд по юзабилити […]

Маркетплейсы и агрегаторы: как крупные коммерческие платформы дополняют государственные ресурсы

Маркетплейсы и агрегаторы: как крупные коммерческие платформы дополняют государственные ресурсы

Пользователь давно перестал делить цифровые сервисы на «государственные» и «коммерческие». Ему важно другое: быстро найти нужную услугу, не ошибиться, получить понятную инструкцию и не тратить время на лишние переходы. Именно поэтому маркетплейсы и агрегаторы всё чаще становятся не заменой, а логичным продолжением государственных ресурсов.

За годы работы с региональными порталами госуслуг я не раз наблюдал, […]

Коммерческие онлайн-сервисы в России: типология, модели монетизации и роль в цифровой экосистеме

Коммерческие онлайн-сервисы в России: типология, модели монетизации и роль в цифровой экосистеме

Когда я проектировал интерфейсы для регионального портала госуслуг, мы постоянно оглядывались на коммерческие сервисы — не потому что хотели копировать, а потому что именно они задавали планку пользовательских ожиданий. Сегодня коммерческий онлайн-сервис в России — это не просто сайт с кнопкой «купить». Это инфраструктурный слой повседневности: через него люди платят, заказывают, общаются, ведут бизнес и закрывают задачи, […]

Почему внешних ссылок недостаточно: техническая готовность страницы к SEO

Почему внешних ссылок недостаточно: техническая готовность страницы к SEO

У внешнего продвижения есть неприятная особенность: можно потратить много сил на ссылки, хотя сама целевая страница ещё не готова нормально участвовать в поиске. Поэтому в эксперименте с топовысок перед ссылочным этапом имеет смысл проверить базовые вещи — отвечает ли акцептор корректным HTTP-статусом, доступен ли Googlebot, нет ли случайного noindex, какой URL указан как canonical и […]

XML Sitemap: что карта сайта сообщает поисковой системе и чего она не исправляет

XML Sitemap: что карта сайта сообщает поисковой системе и чего она не исправляет

XML Sitemap — это файл, в котором сайт сообщает поисковой системе о URL, которые считает важными, и может добавить сведения об их обновлении. Sitemap помогает обнаружению и планированию обхода, но не является командой «проиндексировать эти страницы». Google прямо указывает, что отправка карты сайта остаётся подсказкой: файл не гарантирует ни загрузку каждого URL, ни crawling, ни indexing. […]

Внутренние ссылки и orphan pages: как робот находит страницы сайта

Внутренние ссылки и orphan pages: как робот находит страницы сайта

Google находит новые URL в том числе по ссылкам на уже известных страницах. Для сайта это означает простую вещь: важная страница должна быть не только опубликована, но и встроена в доступный внутренний граф. Если до URL нельзя дойти по обычным внутренним ссылкам, он может оставаться изолированным даже при корректном HTTP-ответе и хорошем содержимом.

Такую страницу […]

Canonical URL и дубли страниц: как определить основную версию документа

Canonical URL и дубли страниц: как определить основную версию документа

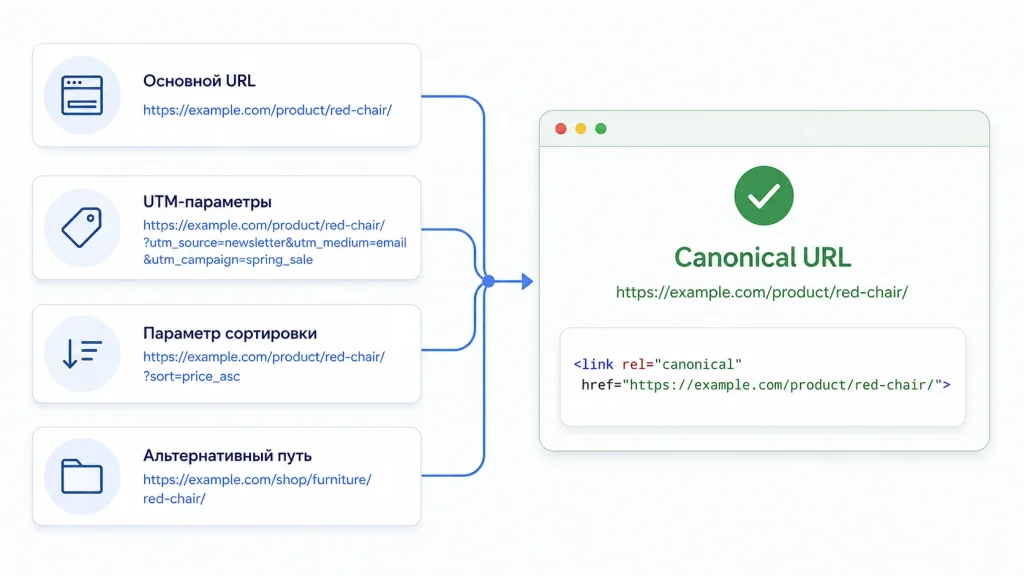
Canonicalization нужна, когда один и тот же или очень похожий основной контент доступен по нескольким URL. Поисковая система группирует такие адреса и выбирает представительный — canonical URL. В Google этот выбор делает сама система: владелец сайта может указать предпочтение, но rel=»canonical» не является безусловной командой.Практическая задача поэтому звучит не как «поставить canonical», а шире: […]

JavaScript и индексирование: что Google получает до и после рендеринга

JavaScript и индексирование: что Google получает до и после рендеринга

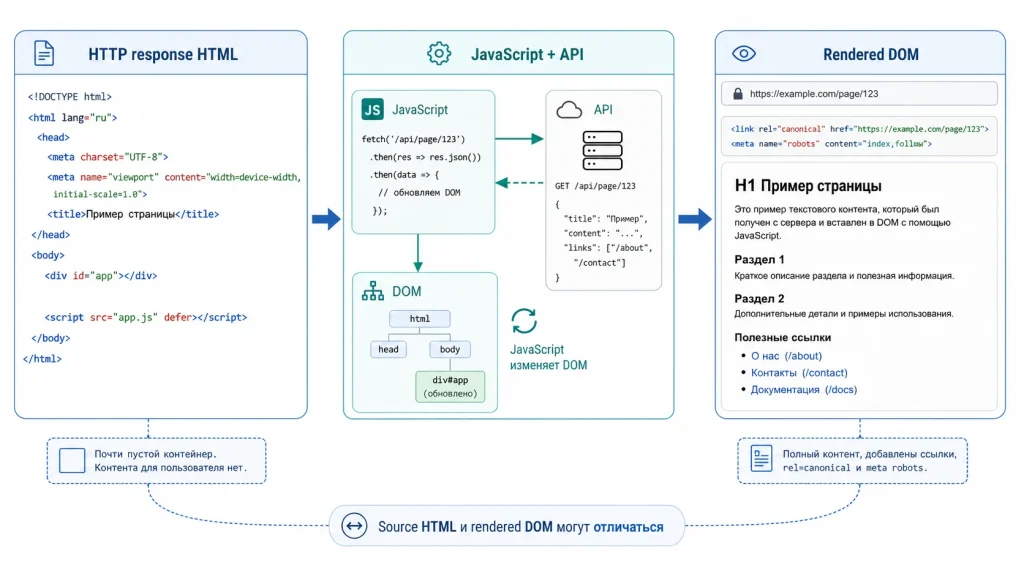
У JavaScript-страницы полезно различать как минимум два состояния: HTML, который сервер вернул в HTTP-ответе, и DOM после выполнения JavaScript. Они могут совпадать почти полностью, а могут отличаться радикально. Например, сервер отдаёт пустую оболочку с <div id=»app»>, а заголовок, текст, карточки, ссылки и метаданные появляются только после запросов к API.

Google умеет выполнять […]