Рубрика: Веб-разработка

URL-параметры и фасетная навигация: как не создавать бесконечные варианты страниц

URL-параметры и фасетная навигация: как не создавать бесконечные варианты страниц

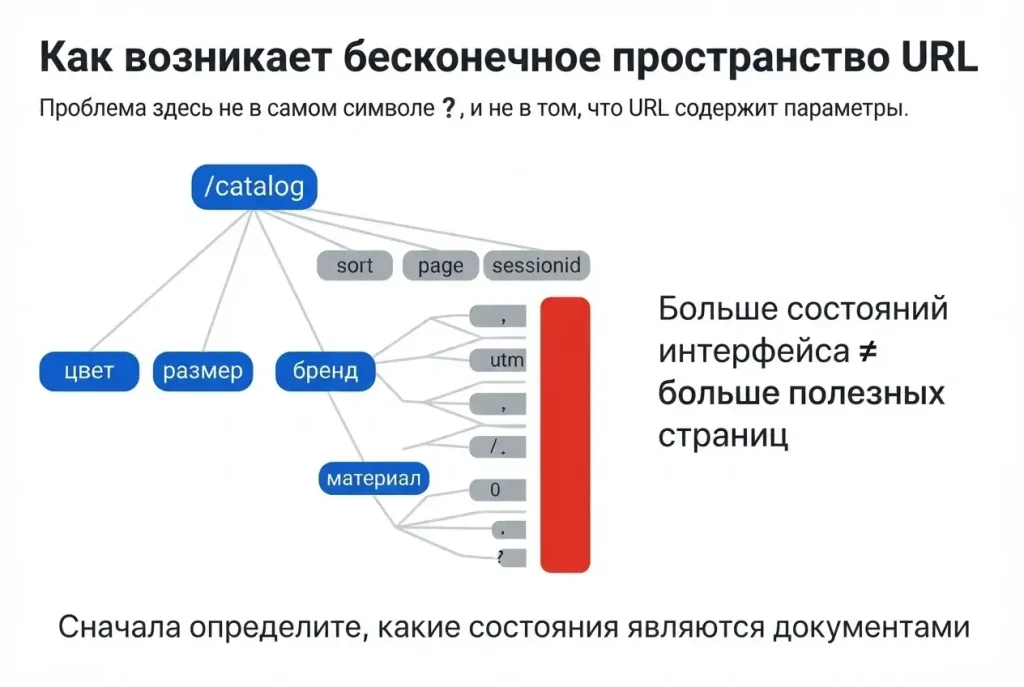
Фильтр по цвету, размеру и бренду выглядит как обычный элемент интерфейса. Но если каждое состояние фильтра получает собственный URL, несколько фасетов быстро превращаются в тысячи комбинаций. Добавим сортировку, пагинацию, метки кампаний и служебные параметры — и один каталог начинает выглядеть для поискового робота как почти бесконечное пространство адресов.

Проблема здесь не в самом символе ? и не […]
HTTP-кэширование: как браузер решает, использовать ли сохранённый ответ

HTTP-кэширование: как браузер решает, использовать ли сохранённый ответ

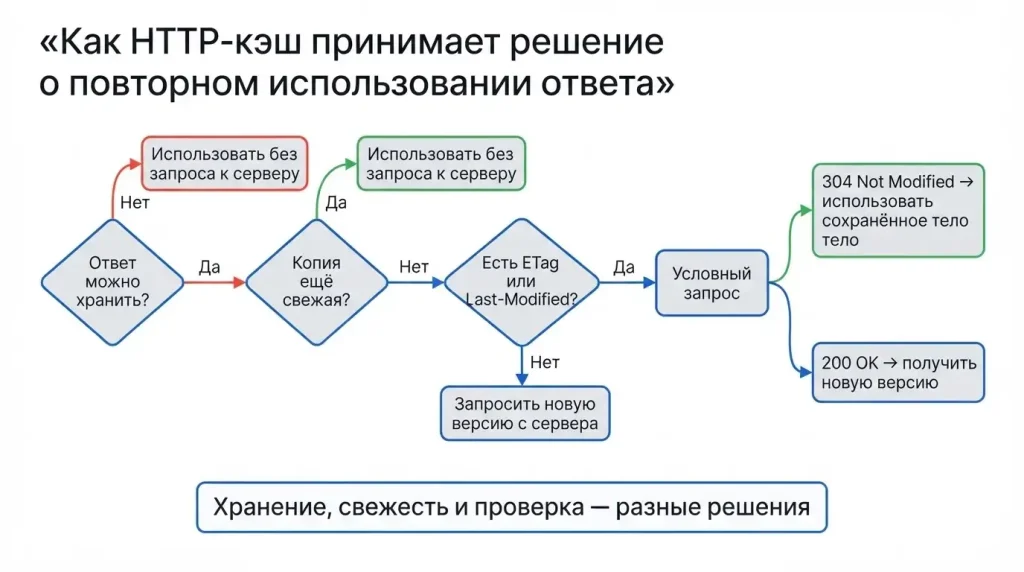
HTTP-кэширование часто описывают слишком просто: браузер «сохранил файл» и потом взял его локально. На практике решение состоит из нескольких отдельных проверок. Сначала нужно понять, разрешено ли сохранять ответ, затем — остаётся ли сохранённая копия свежей, а если срок свежести закончился — можно ли быстро проверить её у исходного сервера без повторной передачи всего тела ответа.

Поэтому […]

Content-Type и MIME-типы: как сервер сообщает браузеру, что именно он вернул

Content-Type и MIME-типы: как сервер сообщает браузеру, что именно он вернул

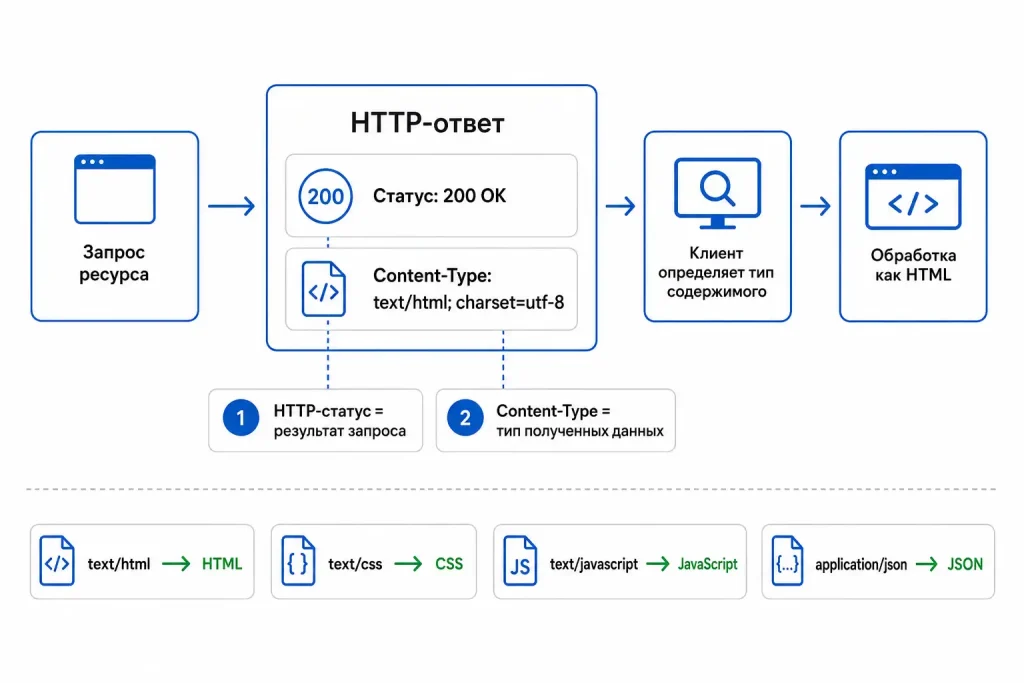
HTTP-ответ состоит не только из статус-кода и содержимого. Клиенту нужно понять ещё одну вещь: что именно находится в теле ответа и как эти данные следует обрабатывать. Для этого сервер обычно передаёт заголовок Content-Type.

Например, два запроса могут закончиться одинаковым статусом 200 OK, но один сервер вернёт HTML-документ, другой — JSON, третий — изображение. Статус […]

Инструменты российского веб-разработчика: IDE, фреймворки, системы контроля версий

Инструменты российского веб-разработчика: IDE, фреймворки, системы контроля версий

Разработка веб-сервиса сегодня — это не про «открыл блокнот и написал страницу». Даже небольшой проект собирается из целого набора инструментов, и от того, насколько осознанно они подобраны, зависит, превратится ли работа в хаос или в предсказуемый процесс. По опыту проектирования интерфейсов для региональных порталов госуслуг могу сказать: когда команда договаривается о стеке на старте, а не […]

Современная веб-разработка в России: популярные стеки и подходы к созданию онлайн-сервисов

Современная веб-разработка в России: популярные стеки и подходы к созданию онлайн-сервисов

Веб-разработка в России перестала быть историей про «взять готовый шаблон и натянуть на WordPress». Сегодня от сервиса ждут скорости, устойчивости под нагрузкой, понятной логики, безопасности и возможности быстро развиваться без переписывания всего проекта с нуля. В реальных продуктах это почти всегда означает продуманный стек, дисциплину в архитектуре и выбор технологий под конкретную задачу, а не […]

Юзабилити-гайд для госпорталов: удобство интерфейсов через призму современных веб-практик

Юзабилити-гайд для госпорталов: удобство интерфейсов через призму современных веб-практик

Госпортал перестал быть «местом, куда заходят по необходимости». Сегодня от него ждут того же, что и от хорошего коммерческого сервиса: понятного сценария, предсказуемой навигации, быстрого отклика и отсутствия лишних шагов. Если интерфейс заставляет думать, где нажать, что заполнить и почему система ругается — пользователь уходит раздражённым, даже если задача формально решена.

Ниже — практический гайд по юзабилити […]

XML Sitemap: что карта сайта сообщает поисковой системе и чего она не исправляет

XML Sitemap: что карта сайта сообщает поисковой системе и чего она не исправляет

XML Sitemap — это файл, в котором сайт сообщает поисковой системе о URL, которые считает важными, и может добавить сведения об их обновлении. Sitemap помогает обнаружению и планированию обхода, но не является командой «проиндексировать эти страницы». Google прямо указывает, что отправка карты сайта остаётся подсказкой: файл не гарантирует ни загрузку каждого URL, ни crawling, ни indexing. […]

Внутренние ссылки и orphan pages: как робот находит страницы сайта

Внутренние ссылки и orphan pages: как робот находит страницы сайта

Google находит новые URL в том числе по ссылкам на уже известных страницах. Для сайта это означает простую вещь: важная страница должна быть не только опубликована, но и встроена в доступный внутренний граф. Если до URL нельзя дойти по обычным внутренним ссылкам, он может оставаться изолированным даже при корректном HTTP-ответе и хорошем содержимом.

Такую страницу […]

Canonical URL и дубли страниц: как определить основную версию документа

Canonical URL и дубли страниц: как определить основную версию документа

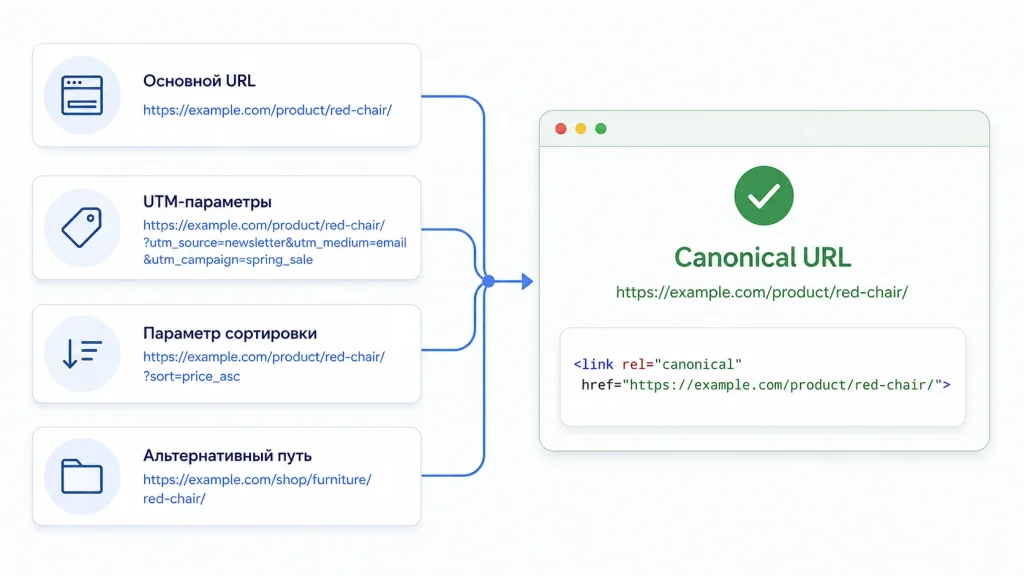
Canonicalization нужна, когда один и тот же или очень похожий основной контент доступен по нескольким URL. Поисковая система группирует такие адреса и выбирает представительный — canonical URL. В Google этот выбор делает сама система: владелец сайта может указать предпочтение, но rel=»canonical» не является безусловной командой.Практическая задача поэтому звучит не как «поставить canonical», а шире: […]

JavaScript и индексирование: что Google получает до и после рендеринга

JavaScript и индексирование: что Google получает до и после рендеринга

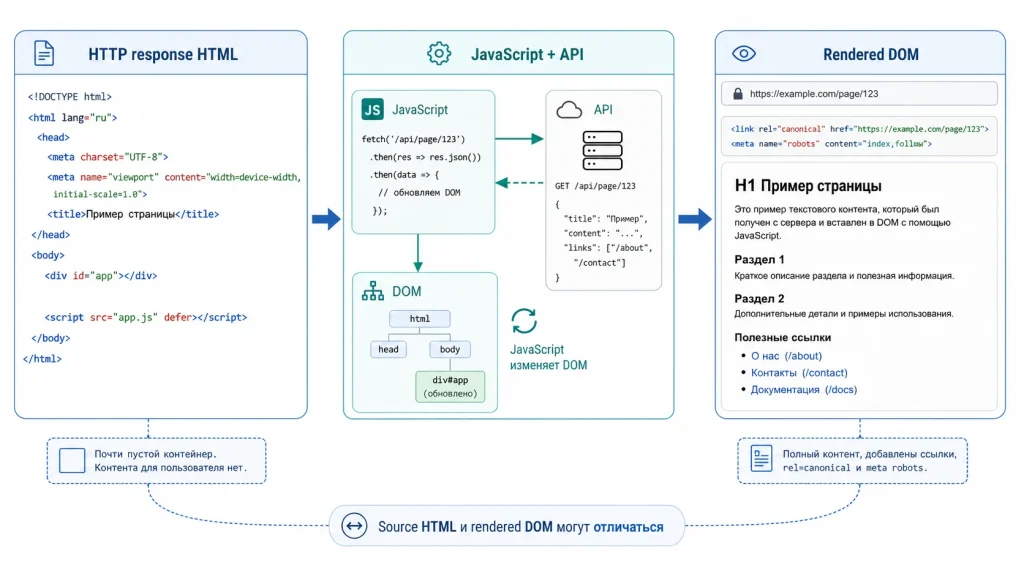
У JavaScript-страницы полезно различать как минимум два состояния: HTML, который сервер вернул в HTTP-ответе, и DOM после выполнения JavaScript. Они могут совпадать почти полностью, а могут отличаться радикально. Например, сервер отдаёт пустую оболочку с <div id=»app»>, а заголовок, текст, карточки, ссылки и метаданные появляются только после запросов к API.

Google умеет выполнять […]