robots.txt, noindex и X-Robots-Tag: три механизма, которые легко перепутать
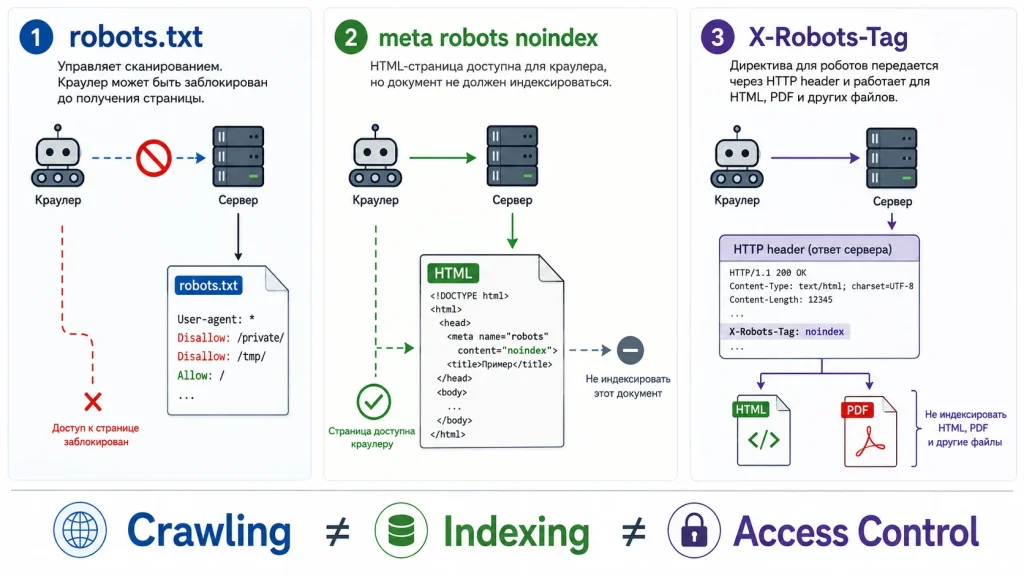
robots.txt, noindex и X-Robots-Tag решают разные задачи. robots.txt управляет тем, какие URL crawler может запрашивать; noindex запрещает показывать полученный документ в поисковой выдаче; X-Robots-Tag передаёт такие же page-level директивы через HTTP-заголовок и особенно полезен для не-HTML файлов. Отсюда следует неочевидное, но важное правило: если закрыть страницу […]